VictoriaMetrics 是后出的一款面向可观测指标的时序数据存储和查询引擎, 传闻比prometheus 查询性能强,存储成本还低,我们也有做指标数据平台,特来学习下
以下分析基于 v1.45.x 版本
1. 核心结论
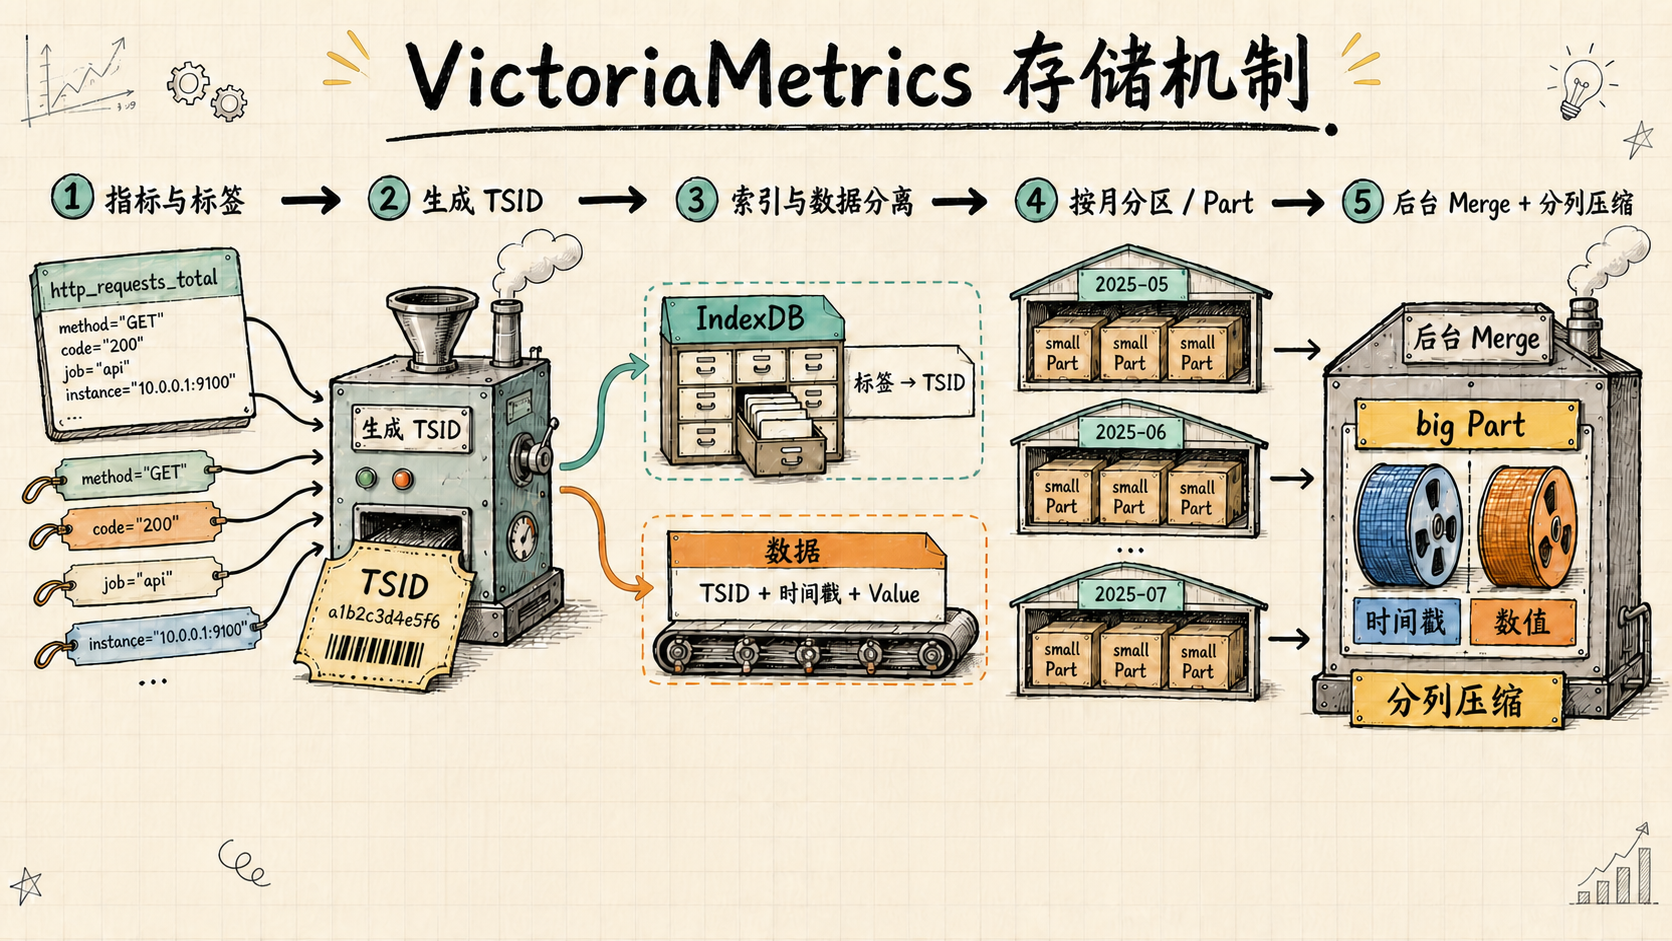
VictoriaMetrics 的存储设计可以概括为以下几点:
- 使用
vminsert、vmstorage和vmselect分离写入、存储与查询职责; - 采用 Prometheus 风格的单值时序模型,每个数据点由时间戳和浮点数值组成;
- 根据指标名和标签生成时间序列标识
TSID; - 将标签索引与原始时序数据分开存储;
- 原始数据按
TSID聚合,并将时间戳和值分别进行列式压缩; - 数据先写入内存,刷盘后形成不可变的
Part,再通过后台 Merge 合并; - 按月建立数据分区,通过
small和big两级目录平衡近期数据的读取速度与历史数据的压缩率; - 索引和数据均采用分层文件结构,通过元索引缩小读取范围;
- 不依赖传统 WAL,在异常退出时可能丢失尚未刷盘的数据。
2. 集群架构
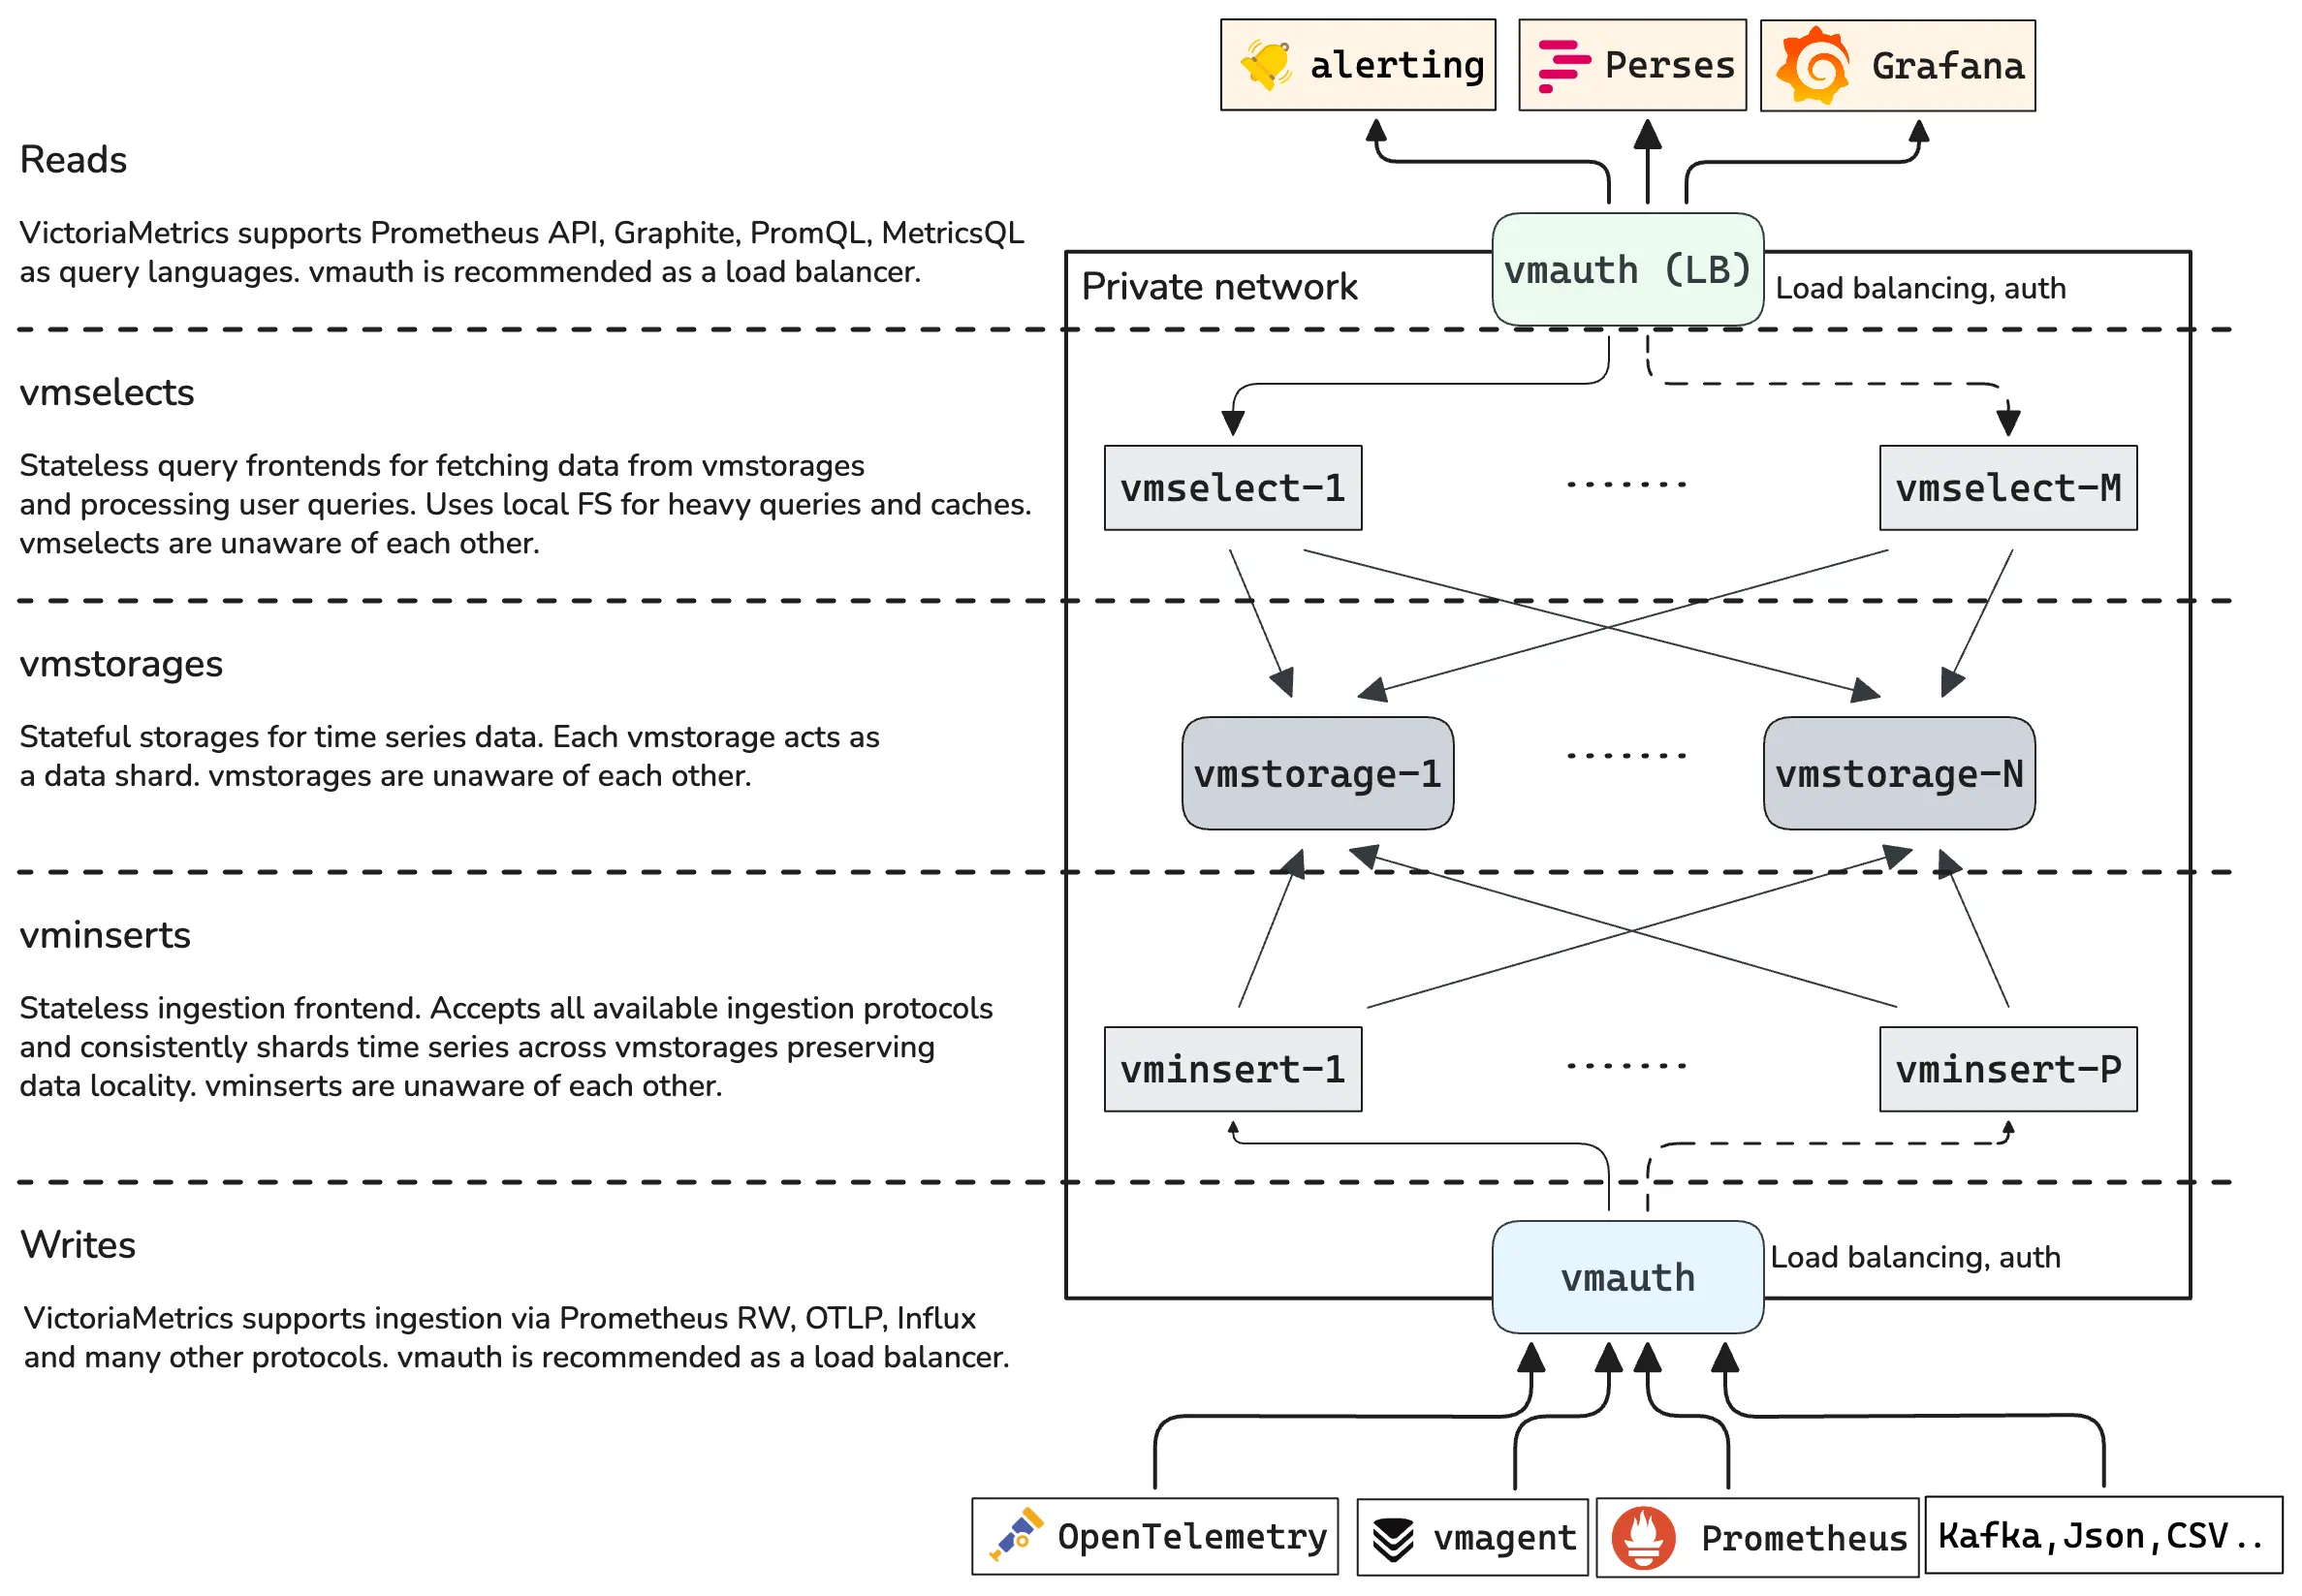
VictoriaMetrics 集群由三个核心组件组成。
| 组件 | 主要职责 |
|---|---|
vminsert |
接收写入请求,通过一致性哈希将数据分发到不同的 vmstorage 节点 |
vmstorage |
保存标签索引和时序数据,并执行本地检索 |
vmselect |
接收查询请求,从一个或多个 vmstorage 节点读取数据并汇总结果 |
三个组件可以分别扩容。vmstorage 采用 Shared-Nothing 架构:节点之间不共享数据,也不需要互相通信。这种结构降低了节点间协调成本,使扩容和故障隔离更简单。
2.1 多租户
集群以 accountID 或 accountID:projectID 标识租户,租户编号位于请求路径中。首次写入数据时会自动创建对应租户。
VictoriaMetrics 主要负责租户数据隔离;身份认证、租户名称、配额和计费等信息通常由前置服务管理。不支持在一个查询请求中同时查询多个租户。
3. 数据模型
https://docs.victoriametrics.com/victoriametrics/keyconcepts/#structure-of-a-metric
VictoriaMetrics 采用单值时序模型。一个时间序列由指标名称和标签集合唯一确定,其数据点由时间戳与浮点数值组成:
1 | MetricName = 指标名称 + 标签集合 |
例如:
1 | ---------------------------------------------------------------------- |
同一时间序列的所有数据点共享相同的指标名称和标签,仅时间戳和值不断变化。value只存储浮点型指标值,不直接支持字符串、布尔值或字节数组等字段类型。
4. 写入时的数据拆分
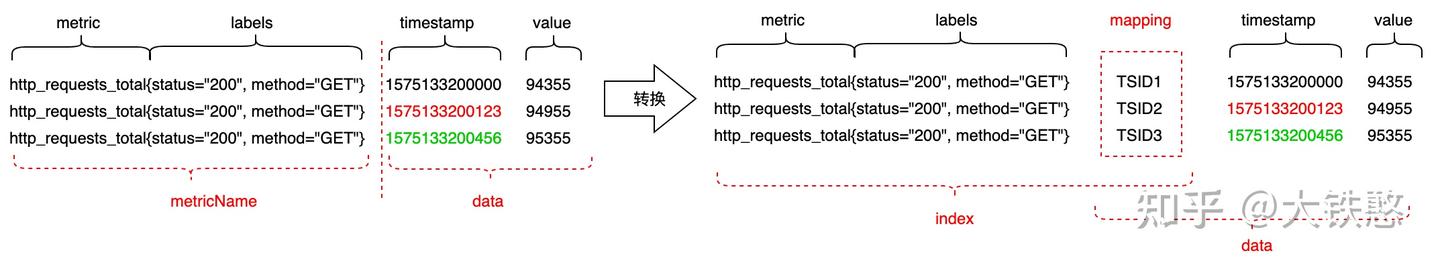
VictoriaMetrics 收到数据后,先根据指标名称和标签集合识别时间序列,并生成内部标识 TSID。随后将信息拆分为两类:
1 | 指标名称 + 标签集合 |
这样做的目的,是避免在每个数据点中重复保存较长的指标名称和标签。标签查询先通过索引获得 TSID,随后再使用 TSID 定位原始数据。
5. TSID 与索引映射
上文所述 TSID 包含以下字段:
MetricGroupID:由指标名称计算得到;JobID:由约定位置的job标签计算得到;InstanceID:由约定位置的instance标签计算得到;MetricID:用于唯一标识时间序列。
其中 MetricID 是始终有效的核心标识。写入新时间序列时,会建立多种映射关系:
1 | MetricName -> TSID |
例如查询:
1 | http_requests_total{status="200", method="GET"} |
索引查询的大致过程为:
- 分别查出指标名称、
status="200"和method="GET"对应的MetricID集合; - 对多个集合求交集;
- 根据命中的
MetricID查出TSID; - 使用
TSID和时间范围查询数据文件; - 根据
MetricID还原原始指标名称与标签。
VictoriaMetrics 的 TSID 的结构如下所示,包含 MetricGroupID、JobID、InstanceID、MetricID
等几个字段,其中除了 MetricID 外,其他字段都是可选的。这个几个 ID 的生成方法如下:
MetricGroupID:是根据MetricName中的MetricGroup使用xxhash的 sum64 算法生成。JobID和InstanceID分别由MetricName中的第一个 tag 和第二个 tag 使用xxhash的 sum64 算法生成。为什么使用第一个 tag 和第二个 tag?这是因为 VictoriaMetrics 在写入时,将写入请求中的 JobID 和 InstanceID 放在了 Tag 数组的第一个和第二个位置。MetricID,使用 VictoriaMetrics 进程启动时的系统纳秒时间戳自增生成。
因为 TSID 中除了 MetricID 外,其他字段都是可选的,因此 TSID 中可以始终作为有效信息的只有 MetricID,因此 VictoriaMetrics 的在构建 tag 到 TSID 的字典过程中,是直接存储的 tag 到 MetricID 的字典。
metricName -> TSID, 即http_requests_total{status="200", method="GET"} -> {metricGroupID=0, jobID=0, instanceID=0, metricID=51106185174286}metricID -> metricName,即51106185174286 -> http_requests_total{status="200", method="GET"}metricID -> TSID,即51106185174286 -> {metricGroupID=0, jobID=0, instanceID=0, metricID=51106185174286}tag -> metricID,即status="200" -> 51106185174286、method="GET" -> 51106185174286、"__name__" = http_requests_total -> 51106185174286
集群以 accountID 或 accountID:projectID 标识租户,租户编号位于请求路径中。首次写入数据时会自动创建对应租户。
6. 磁盘目录
存储根目录的核心内容包括:
1 | storageDataPath/ |
6.1 数据目录
data 下主要包含 small 和 big 两类目录,两者都按月份组织分区:
1 | data/ |
分区以月为单位,例如 2020_11 表示 2020 年 11 月的数据。内存数据每次刷盘都会在相应月份分区中生成一个新的 Part。
Part 目录名编码了以下信息:
- 数据点数量;
- 数据块数量;
- 最小时间戳;
- 最大时间戳;
- 用于保证目录名唯一的标识。
6.2 small 与 big
新刷盘的数据首先进入 small。后台 Compaction 会持续选择若干较小的 Part,将其合并成更大的 Part。
当合并结果超过 small Part 的规模阈值时,输出进入 big。因此,big 中的数据主要来自 small 中 Part 的后台合并,而不是直接写入。
两级目录使用不同强度的压缩策略:
small面向近期、经常查询的数据,使用较低级别的通用压缩,以降低解压成本;big面向较老、较少查询的数据,使用较高级别的压缩,以节省磁盘空间。
这种设计在近期数据查询性能与长期存储压缩率之间取得平衡。
6.3 索引目录
indexdb 保存指标名称、标签、MetricID 和 TSID 之间的映射。索引同样采用 Table、Part 和后台 Merge 的组织方式。
会结合数据保留周期滚动索引 Table。旧索引到期后,系统切换到新的索引目录进行写入。
7. Part 与后台 Merge
Part 是数据和索引的基本持久化单元。它具有两个重要特征:
- 刷盘或合并会生成新的 Part;
- 已生成的 Part 基本保持不可变。
后台 Merge 的主要作用包括:
- 减少 Part 和文件数量;
- 降低查询时需要扫描的文件数量;
- 将小块数据整理为连续的大块数据;
- 提高压缩效果;
- 将满足条件的数据从
small整理到big。
这种模式类似 LSM Tree 的追加写入与后台归并:前台写入避免频繁随机修改已有文件,后台再以顺序读写的方式完成整理。
8. 索引文件格式
一次索引刷盘或合并产生的 Part 主要包含四类文件:
| 文件 | 作用 |
|---|---|
metaindex.bin |
保存索引块的概要信息,用于快速定位 index.bin 中的范围 |
index.bin |
保存各数据块的头部及其位置 |
items.bin |
保存真正的索引 Item |
lens.bin |
保存 items.bin 中各 Item 的长度信息 |
它们形成分层定位关系:
1 | metaindex.bin |
8.1 metaindex.bin
metaindex.bin 保存一组按首个 Item 字典序排列的元索引记录。每条记录包含:
- 当前范围的最小 Item;
- 对应索引块的位置和大小;
- 索引块所含 Block Header 的数量。
文件会被压缩,并在打开 Part 时加载到内存。查询可先对元索引进行二分查找,从而减少需要从磁盘读取的 index.bin 范围。
8.2 index.bin
index.bin 包含多个索引块,每个索引块又包含多个 Block Header。Block Header 记录:
- Item 的公共前缀;
- 当前块的最小 Item;
- Item 数量;
- Item 数据的位置;
- 序列化或压缩类型。
公共前缀只保存一次,items.bin 中的 Item 会去掉这部分前缀,从而减少冗余。
8.3 items.bin 与 lens.bin
items.bin 保存编码后的索引 Item。系统会根据 Item 数量、数据长度和压缩收益决定是否压缩,避免对很小或压缩收益很低的数据强行压缩。
lens.bin 保存每个 Item 的长度,使系统能够从 items.bin 中切分并解析变长 Item。长度数据会先使用面向整数序列的编码,再视情况进行通用压缩。
9. 数据文件格式
一次数据刷盘或合并产生的 Part 主要包含:
| 文件 | 作用 |
|---|---|
metaindex.bin |
按 TSID 和时间范围粗粒度定位索引块 |
index.bin |
保存每个数据块的 TSID、时间范围和数据偏移 |
timestamps.bin |
保存压缩后的时间戳序列 |
values.bin |
保存压缩后的指标值序列 |
分层关系如下:
1 | metaindex.bin |
9.1 数据组织
数据首先按 TSID 分组;同一 TSID 下的数据点再按时间组织。每个数据块只保存一条时间序列的一段数据。
这种组织方式具有明显的局部性:查询某条时间序列时,可以快速跳过其他 TSID 的数据;查询指定时间范围时,也可以通过块的最小、最大时间戳排除无关块。
9.2 列式存储
时间戳和值分别写入 timestamps.bin 和 values.bin。两者的数据特征不同,分开存储后可以使用不同的编码方式:
- 时间戳通常具有固定或近似固定的采样间隔,适合 Delta、Delta-of-Delta 等编码;
- 浮点值在相邻采样之间往往只有少量二进制位变化,适合 XOR 类编码;
- 整数差值可结合 ZigZag 等方式编码;
- 完成时序特征编码后,再根据收益决定是否追加 ZSTD 压缩。
这种“专用时序编码 + 通用压缩”的组合,是 VictoriaMetrics 获得高压缩比的关键。
10. 查询路径
一个典型的标签查询可分为两个阶段。
10.1 索引阶段
- 将查询中的指标名称和标签条件编码为索引 Key;
- 在
indexdb中分别获得对应的MetricID集合; - 对集合执行交集或其他过滤;
- 将命中的
MetricID转换为TSID。
10.2 数据阶段
- 根据时间范围选择相关月份分区;
- 在分区内检查相关 Part;
- 使用
metaindex.bin粗定位; - 使用
index.bin找到匹配TSID和时间范围的数据块; - 从
timestamps.bin和values.bin读取并解压数据; - 合并多个 Part 的结果并返回。
11. 设计优势
VictoriaMetrics 的优势并非来自某个单独优化,而是写入、压缩、查询和扩展机制共同作用的结果。
| 设计维度 | 采用的机制 | 带来的收益 |
|---|---|---|
| 写入 | 内存追加,刷盘生成新的不可变 Part,避免频繁随机修改历史文件 | 缩短前台写入路径,适合持续、高吞吐的时序写入 |
| 存储 | 按 TSID 聚合数据,将时间戳和值分列编码,再结合 ZSTD 与后台 Merge |
利用时序数据的相似性提高压缩率,减少长期磁盘占用 |
| 查询 | 标签索引先筛选 TSID,元索引再根据 TSID 和时间范围排除无关数据块 |
形成逐层剪枝,避免直接扫描全部索引和原始数据 |
| 扩展 | vminsert、vmstorage、vmselect 职责分离,存储节点采用 Shared-Nothing 架构 |
写入、存储和查询可以独立扩容,减少存储节点之间的协调成本 |
| 生命周期 | 数据按月分区,并通过 small、big 使用不同强度的压缩策略 |
便于执行保留策略,同时兼顾近期数据的读取速度和历史数据的压缩率 |
整体来看,这套机制尤其适合写多读多、数据保留时间较长,并且需要按标签筛选时间序列的监控指标场景。
12. 存在的的限制
这些优势也伴随着相应的取舍。主要限制(基于 v1.45.0 )如下:
| 限制 | 形成原因 | 可能影响 | 使用时的关注点 |
|---|---|---|---|
| 高基数标签的索引成本 | 一个标签可能对应大量 MetricID,多条件查询还需要读取多个列表并求交集 |
增加索引读取、集合运算和后续数据扫描成本 | 控制动态标签和标签组合数量,重点评估时间序列基数及标签变化率 |
| 索引查询链路较长 | 查询依次经历标签到 MetricID、MetricID 到 TSID、TSID 到数据块的定位过程 |
缓存未命中或命中序列很多时,磁盘 I/O 与查询延迟可能上升 | 结合典型查询跨度、命中序列数量和缓存命中率进行压测 |
| 未刷盘数据存在可靠性窗口 | 不使用传统 WAL,数据先进入内存再周期性持久化 | 进程或主机在刷盘前异常退出时,尚未持久化的数据可能丢失 | 根据业务可接受的数据丢失窗口设计采集重试、复制和基础设施持久性方案 |
| 数据类型有限 | 存储模型主要围绕数值型监控指标设计 | 不适合直接保存字符串、布尔值或复杂事件对象 | 将日志、事件和复杂对象交给更合适的存储系统,避免强行映射为指标 |
因此,VictoriaMetrics 的设计重点是以较低资源成本保存和查询大规模数值指标,而不是提供通用数据类型、强事务语义或任意维度分析。选型时需要用实际基数、查询模式和可靠性目标验证这些取舍是否能够接受。
13. 总结
VictoriaMetrics 的核心思路是:
使用标签索引找到时间序列,再使用 TSID 定位按列压缩的时间戳和值;通过不可变 Part、按月分区和后台 Merge,实现高吞吐写入、高压缩率及可扩展查询。
从存储引擎视角看,它主要围绕四个目标进行权衡:
- 通过追加写和后台合并提升写入吞吐;
- 通过索引与数据分离支持标签检索;
- 通过时序专用编码和分层压缩降低长期存储成本;
- 通过组件解耦和 Shared-Nothing 架构实现水平扩展。
相应代价是后台合并带来的资源消耗、高基数场景的索引压力,以及未刷盘数据的可靠性窗口。评估 VictoriaMetrics 时,应结合时间序列基数、标签变化率、查询跨度、磁盘余量和可接受的数据丢失窗口进行容量规划。
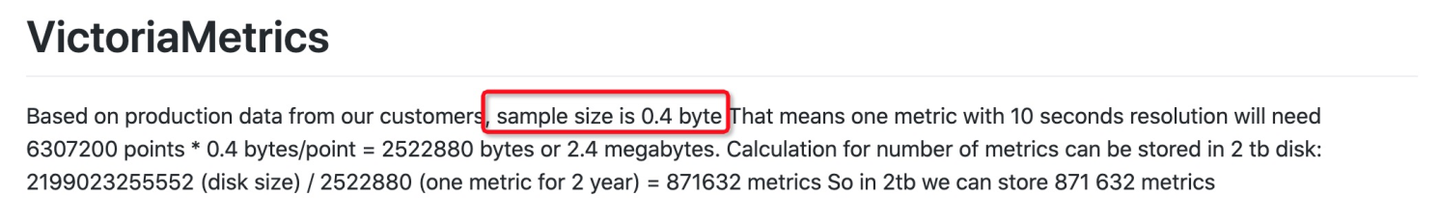
Ps , 单样本能压缩到 1 byte 以下, 真的厉害~